
如何借助 Claude 实现自助式数据分析(原文)| Data Analytics with Claude AI by Anthropic
- 类别:企业 AI
- 产品:Claude Code
- 日期:2026 年 6 月 3 日
- 阅读时间:5 分钟
- 分享:https://claude.com/blog/how-anthropic-enables-self-service-data-analytics-with-claude

正如许多数据科学和数据工程团队都能证明的那样,让业务分析实现自助化,传统上一直是一件艰苦而低效的事。
为了让技术能力较弱的同事更容易使用数据模型,团队往往会创建宽表和去规范化表 (wide and denormalized tables)。但随着业务扩展,这通常会导致视图相互重叠、定义不一致,而且对于那些并不想学习 SQL 的员工来说,也并不能真正弥合能力差距。另一种做法是为用户创建更受限制的环境,但这往往无法覆盖大量长尾业务问题,并且随着团队各自为政,会导致指标和仪表盘膨胀。
LLM 的兴起为自助式分析提供了一条新的路径,可以避开上述挑战。然而,如果只是把 Claude 指向数据仓库,然后让 agent 自行执行任务,也可能制造出一种“精确”的错觉。
起初,人们会因为摆脱临时数据请求而感到兴奋;但很快,这种兴奋会变成担忧——因为他们意识到,这种设置把利益相关者与底层基础设施、文档和专业知识隔离开了,而过去正是这些因素引导他们使用经过精心治理的数据集。
在 Anthropic,95% 的业务分析查询通过 Claude 自动完成,整体准确率约为 95%。通过把这些通常机械、重复的工作交给 Claude,我们的数据科学团队得以专注于更具战略意义的工作,例如因果建模、预测和机器学习。
在与数十位 Anthropic 顶级 Claude Code 用户交流,并观察了大量分析 agent 的设计模式之后,我们总结出了一些面向其他使用 LLM 的数据团队的最佳实践。本文将分享这些建议和方法,帮助最大化 Claude 驱动自助式业务洞察的能力,包括:
- 为什么分析准确性是一个上下文与验证问题,而不是代码生成问题;
- 导致大多数错误的三种失败模式;
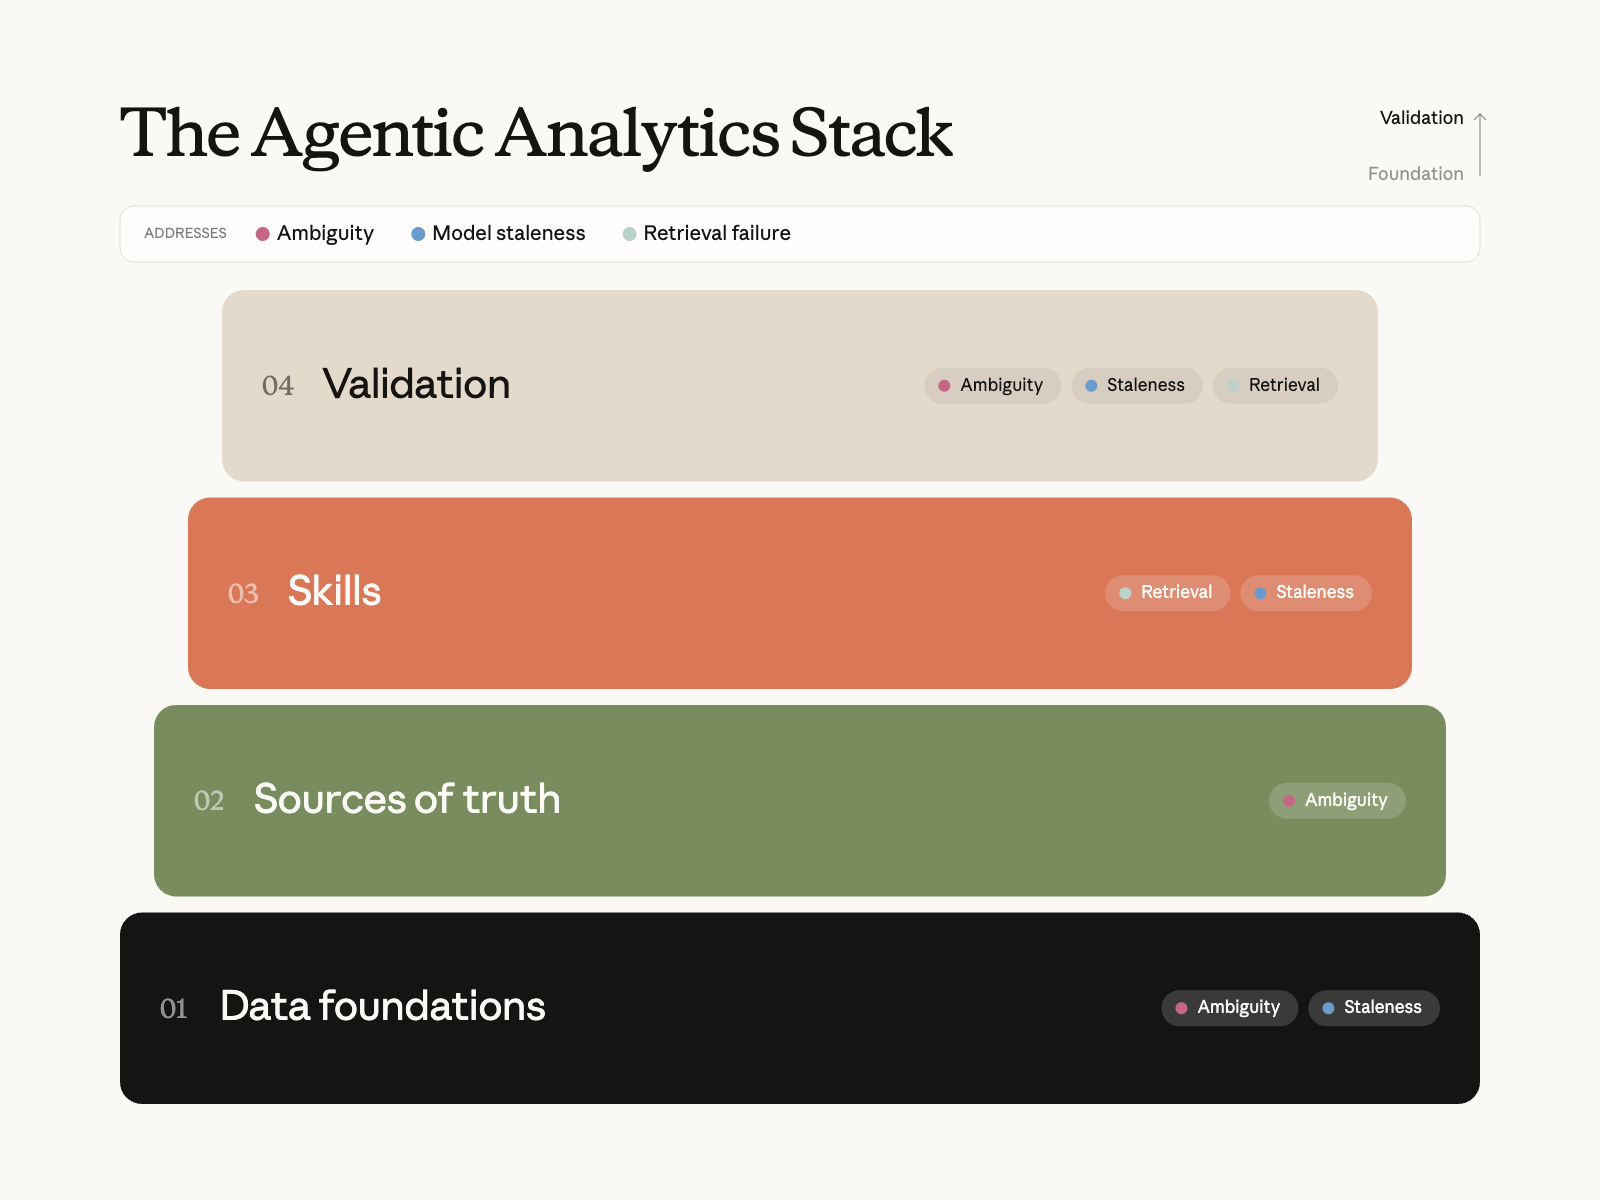
- 我们为解决这些错误而构建的 agentic analytics stack;
- 我们如何衡量有效性;
- 我们如何创建大部分技能的基础模板(见附录)。
数据不是软件
LLM 的生成能力是一把双刃剑:使其能够针对复杂问题提出创造性解决方案的机制,也可能导致其产生错误的幻觉输出。要充分理解分析 agent 面临的挑战,将它们与编码 agent 进行比较会很有帮助。
编码是一个开放式的问题空间,会奖励模型的创造力;同时,文档和测试也为防止幻觉提供了天然护栏。相比之下,在分析场景中,通常只有一个正确答案,且该答案来自一个正确的数据源,而我们往往没有确定性的方法来证明它的正确性。
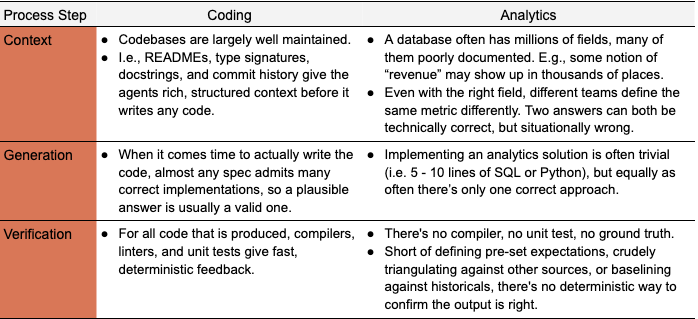
对于自助式 agentic 业务分析而言,复杂性主要来自数据的歧义。核心问题可以归结为:我们是否能够把用户的问题映射到数据模型中具体且最新的实体,并知道正确的使用方式。如果我们能够做到这一点,那么后续的执行和 SQL 生成就会变得简单。
我们发现,这个问题有三个属性解释了绝大多数不准确回答:
- 概念 <> 实体歧义:在一个数据模型中,可能有数百个可行选项(而字段总数可能达到数百万),agent 无法选择最能回答用户问题的正确字段。例如,在衡量活跃用户数量时:哪些行为算作“活跃”?是否包含欺诈用户?使用多长的回看窗口?
- 数据陈旧:数据源、业务定义和 schema 不断变化;资产和 agent 的知识会过时,并开始返回细微但错误的答案。
- 检索失败:正确的信息实际上可能存在于数据模型中,并且已被正确标注,但由于搜索空间过于庞大,agent 就是找不到它。
curl -fsSL https://claude.ai/install.sh | bashOr read the documentation
我们的 agentic analytics stack
在 Anthropic,我们减少这三类错误的主要方式,是通过我们的 agentic data stack。每一层主要用于应对其中一个或多个问题:
- 实体歧义:数据基础和事实来源会缩小可能实体的空间,直到只剩下一个经过治理的答案。
- 陈旧性:维护和验证流程确保所有内容不会随着业务变化而腐化。
- 检索失败:skills 确保 agent 能够可靠地找到并正确使用那个答案。
本节中,我们将讨论如何构建每一层。
数据基础
确保分析 agent 准确性的最重要方面,是建立强大的数据基础。这包括数据仓库中的数据模型、转换、测试和表,以及描述它们的元数据。标准的数据工程和数据质量实践仍然适用,例如维度建模、shift-left 测试,以及关键 pipeline 的新鲜度和完整性检查等(这些我们不会重新展开讨论)。
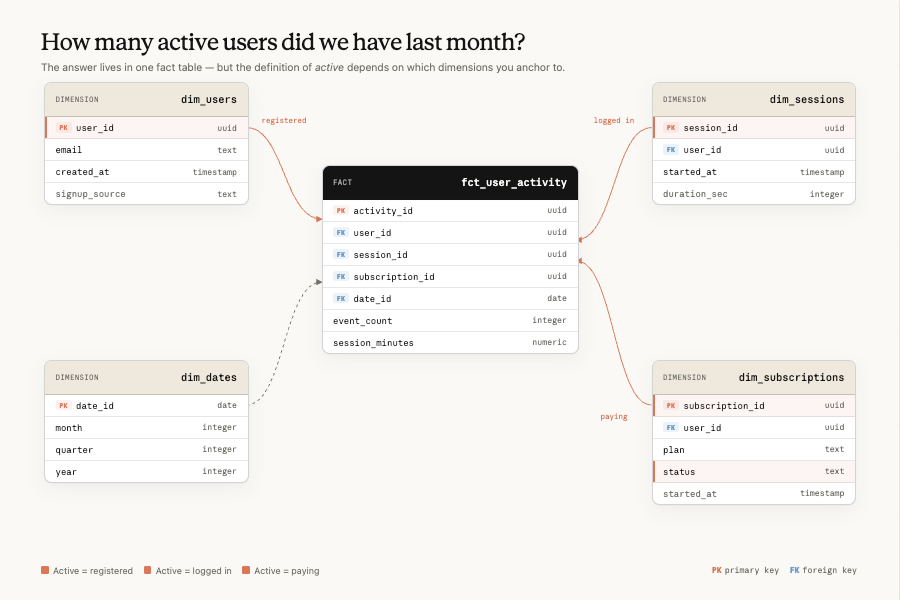
标准的数据工程实践,例如维度建模,依然和过去一样重要。
发生变化的是,数据模型的最终用户不再是数据专家(例如数据科学家),而是代表用户行动的 agent;这些用户对数据的专业程度和对底层基础设施的理解程度各不相同。这种变化带来的挑战在于,结果不能要求用户自己验证底层正确性,因为最终用户并不知道如何验证。
数据基础层主要面向歧义问题:例如,如果“收入”能够解析到一个经过治理的数据集,而不是四十个看似合理的候选项,那么在 agent 开始搜索之前,问题在很大程度上就已经消失了。这一层也是防止陈旧性的第一道防线,因为定义规范模型的同一个代码库,自然也是强制它们保持最新的地方。
我们发现以下几种实践尤其有效:
- 创建规范数据集:最常见的失败情况,是 agent 无法把一个概念(例如“产品 X 的收入”)映射到唯一正确的表、列和指标定义,通常是因为存在多个看似合理但实现方式略有不同的候选项。解决方法是减少逻辑模型的数量,并对这些模型实施更严格的治理:整理出一小组规范的、单一事实来源的数据集,这些数据集要有明确负责人、可直接消费、易于发现,然后积极淘汰那些近似重复的数据集。物理层面的汇总表和缓存对于成本与性能仍然重要,但它们应该从规范模型机械派生出来,而不是作为替代项并列存在。目标是:当 agent 搜索某个概念时,它只能找到一个经过治理的答案。
- 强制执行标准:我们发现,只有当规范模型和指标定义通过工具、CI 和组织要求得到强制执行时,数据基础才会真正稳固。工具层面,agent 会被结构性地优先路由到这些模型(下文会进一步说明);CI 层面,绕过这些模型的变更无法通过审查;组织要求层面,下游团队必须基于治理层构建,或说明为什么不这样做。否则,没有执行力的治理很快会退化回“多个候选项”的问题。
- 共置工件:我们应对不断变化的数据模型和业务逻辑的主要防御手段是共置。几乎所有数据代码(即建模、语义层、参考文档、规范仪表盘定义)都位于同一个代码库中,并通过 CI 检查保护跨层完整性。如果某个建模变更会破坏下游仪表盘,或使已文档化的指标失效,CI 会标记出来,并且修复会在同一个 PR 中一起提交。(我们会在后面的 Skills 部分回到这一机制的细节。)
- 把元数据视为一等产品:编码 agent 表现良好,部分原因在于代码库是可读的:README、类型签名、docstring 等。你的数据仓库同样可以做到可读,但前提是列和表描述、规范指标定义、粒度文档、合法取值范围、血缘关系、所有权和模型分层等元数据,都要以与数据转换本身同等的严谨程度进行维护。虽然这并不是一个新的洞见,但良好的治理能够提供关键上下文,帮助 agent 选择正确的数据集。
事实来源
如果说数据基础是数据仓库本身,那么事实来源就是 agent 用来导航数据仓库的参考界面。这一层会降低“概念 <> 实体”的歧义,并把利益相关者问题中的“周活跃用户”转化为数据模型中一个具体、经过治理的实体。大致按照可信度从高到低排列:
- 语义层:已编译的指标和维度定义。如果一个问题能够清晰映射到某个已定义指标,agent 就会调用一个函数并获得一个数字,这个数字与公司中其他所有界面产生的数字一致。我们的 agent 在结构上被要求(通过 skill 指令)首先使用语义层(见附录)。我们尝试过一个没有成功的想法:让 LLM 基于原始表和查询日志自动生成指标定义,以此引导语义层建设。结果它生成了看起来合理的定义,但这些定义编码了我们原本试图消除的歧义;在我们的评估中,相比一个更小但由人工维护的语义层,这种做法整体是负收益。因此,我们建议用 Claude 生成文档,但由人类负责定义本身。
- 血缘关系和转换图:当语义层无法覆盖某个问题时,血缘关系和表排序(基于引用次数)可以让 agent 推理:哪些上游模型支撑了某个概念,哪些模型已被弃用,哪些模型共享相同粒度。这会把“我不知道这个指标”转化为“我知道应该从哪个治理模型聚合”。这也是我们在下文在线验证中展示的新鲜度和来源信号的基础。
- 查询语料库:来自仪表盘、notebook 和历史分析的 SQL。直觉上,这应该很有价值:它记录了已经被正确回答过的每一个问题。实践中,我们发现,给 agent 直接检索数千条历史查询的权限,对准确率提升不到一个百分点(我们会在后面的消融实验部分说明)。非结构化检索无法把一个新问题映射到正确的先例。真正有效的是把这些语料提炼为结构化的领域参考文档,以及 skills 中描述的可复用分析模式。应当把查询历史视为用于整理的原材料,而不是 agent 直接读取的事实来源。
- 业务上下文:这是大多数团队会跳过的一层,也是我们长期低估的一层。不理解业务的 agent 会回答用户“问了什么”,但不一定会回答用户“真正想问什么”。它不会知道“Q2 发布”指的是某个具体产品,也不会知道两个团队对同一个术语有不同定义,更不会知道这个问题之所以被提出,是因为周四有董事会会议。我们接入了一个公司知识图谱,其中包含被索引的文档、路线图、决策日志和组织结构,让 agent 能够解析环境中的隐含引用,并提出更好的澄清问题。
这四者共同的失败模式,和数据基础层中的问题相同:文档质量差或已经过时。Claude 在弥补这一差距方面非常有用,例如起草列描述、基于查询模式提出指标文档、在 CI 中标记未文档化模型等;但整理和所有权仍然由人类管理。
在接下来的两节中,我们将讨论如何让这种所有权足够低成本,以至于它真的会发生。
Skills
如果事实来源是 agent 的声明式知识(即某个指标是什么意思),那么 skill 就是它的程序性知识:应该按什么顺序查阅哪些来源,如何处理有歧义的数据,以及一个完整分析应该是什么样子。
在 Claude Code 中,skill 是一个由 markdown 文件组成的文件夹,agent 会按需读取。在 Anthropic,我们开发的 skills 带来了巨大的价值增量。没有 skills 时,Claude 在我们的评估中准确回答分析问题的能力没有超过 21%。加入 skills 之后,整体准确率稳定超过 95%,并且在某些领域经常达到约 99%。请参见附录,我们在那里给出了一个用于创建大部分 skills 的骨架模板。
一些最佳实践:
创建成对 skills:knowledge skill 作为一个轻量的顶层路由器,使更多领域细节能够按需加载。它会告诉 agent:“首先尝试语义层;如果没有覆盖,这里有约 30 个该领域的参考文件,描述相关表、列、join 和注意事项。” 从效果上看,这个路由器是我们对检索失败的回应:与其让 agent 搜索一个拥有百万字段的数据仓库,不如在写查询之前,就把搜索空间缩小到几十个经过整理的文件。unbook skill 则编码了一名资深分析师会遵循的流程:澄清问题、通过 knowledge skill 找到数据源、运行查询,然后让结果通过对抗性审查 sub-agent 进行循环检查。它还打包了十几个可复用分析模式(留存曲线、比率拆解、漏斗分析),因此常见请求不需要每次重新发明。
创建合适的参考文档:参考文档应面向 LLM 检索来编写。我们的参考文档描述表(粒度、范围和排除项)、注意事项的机制(例如,“排除已知免费邮箱域名,但保留 anthropic.com 这样的自定义域名”),以及明确的路由触发条件(例如,“如果问题是关于实验提升……不要用于原始事件计数”),但不会写那些容易过时的强制性配方。下面是我们用于创建参考文档的骨架。
# [Domain] Tables

## Quick Reference
### Business Context — [what this domain means in plain words]
### Entity Grain — [what one row represents]
### Standard Hygiene Filter — [the filter every query in this domain applies]

## Dimensions
- [How the key dimensions are encoded, and how the same concept is named
  differently across tables]

## Key Tables
### [table_name]
- **Grain**: [...] · **Scope/exclusions**: [...]
- **Usage**: [when to use it, when NOT to, join keys, required filters]
[... one short section per governed table ...]

## Gotchas
- [The wrong-answer modes a senior analyst would warn you about]

## Best Practices / Common Query Patterns
- [Default choices, standard cuts, worked patterns where the exact query
  form is the hard part]

## Cross-References
- [Neighboring domain docs that own adjacent questions]
把 skill 维护视为一等事项:skill 文档描述的是每天都在变化的数据模型,因此如果没有主动维护,几周内就会变错。我们曾看到,发布时约 95% 的离线准确率,在一个月内漂移到约 65%,直到我们把它当作一个工程问题来处理。这意味着把 skill markdown 文件与转换模型放在同一个代码库中;改变模型的 PR,也就是更新描述该模型文档的同一个 PR。一个代码审查 hook 会标记任何修改 reporting model 但没有触及 skill 文件的变更。现在,大约 90% 的数据模型 PR 都会在同一个 diff 中包含 skill 变更。随着模型改进、过去的失败模式不再适用,我们也会定期精简 skill 脚手架。
在所有界面上创建一致且无缝的体验:同一个 skill 必须在 Slack、IDE、仪表盘工具和独立 agent 会话中,对同一问题给出同一答案。我们通过确保只有一个规范来源(数据代码库),并让 skill 变更自动同步来实现这一点。合并后,skill 会同步到插件市场(面向 IDE 用户)、云存储 blob(面向读取单一文件的托管应用),并通过 MCP 直接作为资源提供。我们从一开始就为可移植性做设计,避免硬编码代码库路径和特定界面的命名空间。
验证
最后,验证是你发现三种失败模式中哪一种仍在泄漏的方式。
离线评估
我们常看到一种模式:数据团队会搭建复杂的分析环境,却没有任何流程来理解分析 agent 的准确性。
弥补这一缺口的一种方式是离线 eval,也就是简单的问题 / 答案对。你可以把离线 eval 理解为类似机器学习模型的离线测试:它们不能告诉你线上 agent 的真实表现,但可以很好地帮助你判断是否存在关键缺口。
在 Anthropic,我们部署两类离线 eval。基于仪表盘的 eval 由 Claude 自动生成(随后由人类验证),覆盖利益相关者最常问的问题。长尾 eval 则是我们把业务上下文(路线图、表文档)提供给 Claude,让它在该领域其余部分生成合理问题。每当利益相关者在对话线程中纠正 agent 时,我们也会持续收集这些纠正,因为它们都是候选 eval。
其他最佳实践包括:
- 锚定真实值,防止漂移:针对实时数据编写的 eval,在底层数字变化的那一刻就会过时。应将每个 eval 固定到某个快照日期,基于稳定事实表编写,或让评分器判断 agent 的查询而不是数字本身。将 eval suite 接入 CI,这样触及依赖项的 PR 会重新运行受影响的 eval。
- 像存储遥测数据一样存储结果,而不是像测试日志一样存储结果:每次运行都会落到数据仓库表中,包含 skill 版本、git SHA、模型 ID、每条断言的通过 / 失败、token 数和耗时。“这个变更有帮助吗?” 会变成一个查询,而你也能获得时间序列,用于发现单次 CI 运行无法捕捉的缓慢回归。
- 按领域设置发布门槛:领域负责人不能在其 eval 集合的对应部分达到某个阈值之前,向利益相关者宣布 agent 可用(我们最初使用约 90%)。这会迫使团队在用户看到失败之前修复参考文档。
- 创建适当数量的 eval:你应该拥有多少 eval,取决于业务领域的复杂性和底层数据模型的复杂性。可以通过跟踪离线准确率对线上准确率的预测效果进行校准:我们发现,每个主题(例如“增长”)超过几十个 eval 之后,收益会递减;而且随着每一代新模型出现,这个上限还会下降。
离线 eval 准确率应该接近 100%;每一个正确答案也都应该命中你的语义层(如果你有语义层)。再次强调,这种准确率并不意味着你的系统不会产生错误答案;它只是说明,在你拥有适当 eval 覆盖的前提下,没有明显缺口。
消融技术
关于 skill 的每一个结构性决策,例如暴露哪些来源、某个 sub-agent 是否值得增加延迟、是否把两个 skills 合并为一个,我们都会在固定离线 eval 集的条件下做出。
我们只改变一个组件,然后比较通过率。每次运行只需要一个小时,却能替代大量争论。方法论比任何单个结果都更重要:
- 为零结果而设计:我们最有用的一次消融是一个负结果。我们给 agent 直接 grep 我们全部仪表盘、转换和分析师 notebook SQL 的权限(数千个文件)。随后我们在 transcript 中验证,它确实在每次回答前读取了这些文件。准确率在两个方向上的变化都不到一个百分点。然后我们检查明显的混杂因素:在它答错的问题中,答案是否实际上存在于语料库中?大约 80% 的情况下是存在的。“答案存在”是否能预测“现在能答对”?不能,翻转率是平的。信息在那里,agent 也看到了,但它仍然没有使用它。这个单一实验告诉我们,瓶颈不是无法访问历史工作,而是结构问题(即把问题映射到正确实体)。这个洞见改变了之后几个月的路线图。
- 以 PR 粒度做消融:每一次有意义的 skill 编辑,都要在相关 eval 子集上运行变更前 / 变更后的对比,并把差异写入 PR 描述。这能让“我改进了文档”保持诚实,并捕捉一种出人意料但很常见的情况:一个出于好意的新增内容反而让结果变差。
- 保留一份简短的“无效做法”列表:我们自己的两个例子是:在某个点之后继续叠加更多轮文档打磨(我们连续三次迭代都是净负收益:文档变得更长,而不是更好),以及把对抗性 reviewer 换成更便宜的模型以降低延迟(它失去了大部分准确率收益,却没有真正带来速度提升)。负结果的记录成本很低,而且能防止下一个人重复同样的实验。
在线验证
最后一步,是确保实际线上系统的表现尽可能准确。我们采取的一些措施包括:
- 对抗性审查:我们发现,使用一个 Claude skill 来激烈挑战潜在最终答案的所有底层假设,可以让 eval 集中的准确率提高 6%,但代价是 token 增加 32%、延迟增加 72%。
- 来源页脚:每个回答都带有一个页脚,说明它来自哪个来源层级(语义层 › 整理过的参考资料 › 原始表)、底层数据有多新,以及模型负责人是谁。它不会让答案本身更正确,但可以帮助消费者判断应该在多大程度上信任该回答。“原始表,新鲜度未知”的页脚,是在向上转发之前需要验证的信号,也是我们对静默失败为数不多的缓解措施之一。
- 数据质量检查:你的 agent 可能使用了正确字段,也以合适方式使用了它,但数据本身可能是错误的。加入基本的数据质量检查,确保被引用字段是最新的、完整的、没有异常,通常是一种良好卫生实践。
- 被动监控:我们持续跟踪两个生产信号:agent 查询中通过语义层解析的比例,以及回答中使用纠正性语言的比例(例如“那是错误的表”、“你漏掉了欺诈过滤器”)。两者都会进入一个仪表盘,并与离线通过率一起每周审查。
- 主动收集纠正:这是闭环的关键部分。一个定时 agent 每隔几小时扫描一次利益相关者频道,寻找类似的纠正性语言,针对相关参考文档起草一行修复,并打开一个标记给领域负责人的 PR。修复路径被刻意设计得很无聊——编辑一个 markdown 文件、合并、自动同步到各处——这样领域负责人就不会在这项任务上花太多时间。同样的纠正也会反馈到离线 eval 集中。
所有这些措施仍然无法完全捕捉的一种失败模式,是静默失败。答案是错的,但看起来合理,并且在没有异议的情况下被使用。我们的缓解措施包括来源页脚、对任何面向领导层的内容要求明确的人类签核,以及为每个领域的核心 KPI 设置常驻 eval,每天与被认可的仪表盘进行 sanity check;不过我们目前还没有一个稳健的解决方案。
如何开始
如果你从零开始,那么少量规范数据集、几十个离线 eval,以及一个轻量 knowledge skill,就能捕获大部分收益;本文中其余内容,都是我们在这些基础建立之后逐步添加的。
我们也分享了许多最佳实践,但并不是所有实践都适合每个数据团队。你可以通过以下问题,与组织对齐几项会影响方法选择的原则:
- 今天给出正确答案与未来给出正确答案,哪个更重要? AI 模型正在快速进步。我们经常看到一些公司为弥补当前模型短板而构建大量基础设施,但一旦模型改进,这些基础设施就变得不再必要。了解模型短板所在,并等待模型改进来填补缺口,开销要小得多,但未必符合你公司的风险承受能力。
- 你预计业务复杂性会如何随时间变化? 如果你产生的数据不多、输出消费者很少,或者数据模型很可能保持简单,那么我们讨论的一些流程可能过于复杂。
- 输出的目标受众有多技术化? 换句话说,如果你为能够识别错误答案的数据科学家构建这个分析系统,那么相比受众完全不熟悉底层数据模型的情况,你可能更能容忍错误。
- 你愿意为提升准确性花多少钱? 我们发现,某些流程(例如对抗性验证)可以显著提升准确性,但通常会带来更高成本和更高延迟。
- 你对访问控制和内部数据隐私的舒适程度如何? agent 通常在拥有更多上下文时表现显著更好;然而,广泛的数据访问通常与大多数公司的治理姿态相冲突。这会决定你是在构建一个 agent,还是构建多个有范围限制的 agent。
无论你选择哪条路径,我们最大的收益都来自于应对这三种失败模式:把歧义压缩为一个经过治理的答案,让答案易于发现,并在答案或发现路径过时时进行标记。
本文由数据科学和数据工程团队成员 Chen Chang、Clement Peng、Justin Leder、Johanne Jiao 和 Josh Cherry 撰写。作者感谢 Michael Segner 的贡献。
附录
Skill 文件骨架
下面是我们主要 warehouse skill 的骨架:它保留了真实文件的结构,但内部细节被替换为方括号占位符。它并不是为了让你逐字复制,而是为了展示我们认为值得写下来的章节类型。
---
name: [warehouse-skill]
version: [x.y.z]
description: "IF the user asks to query [the company]'s data warehouse for any
  [list of business domains] question — THEN invoke this skill. DO NOT invoke
  for [adjacent engineering tasks] or questions with no data-warehouse component."
---

# [Warehouse] Skill Instructions

## Description
The single source of truth for safe and effective [warehouse] querying.
Referenced by other skills [listed] for query execution guidance.

Act as a Data Analyst, providing strategic insights and data-driven
recommendations but seek guidance along the way.

**Out-of-scope decisions**: [product areas, etc.] → surface data only,
state "decision is [owning team]'s call", do NOT take a position or author
code fixes.

## Executing queries
Priority:
1. **[Managed connection]** (if available): [query tool] / [schema tool]
2. **[CLI fallback]** (if installed): [default project, fallback project]
3. **Neither** — ask the user to authenticate, then stop

---

# Semantic Layer (REQUIRED first step)

The governed semantic layer is the **mandatory default path** for every data
question — same numbers as [the BI tool], joins/grain/filters baked in. Raw SQL
via the reference docs below is the **fallback**, used only after the
semantic-layer path is shown not to cover the ask.

## Required workflow
1. **Load** — [how to load the semantic layer in each runtime, with fallbacks]
2. **Discover** — search measures/dimensions by keyword; **always check
   segments** (the named canonical population filters — hand-rolled WHERE
   clauses for these are the dominant wrong-answer mode)
3. **Compile + run** — build the spec → compile to SQL → execute
4. **Fallback** — only if discovery finds no relevant metric or compile fails
   → raw SQL via `references/*.md` (PART 3 below)

> **Don't bail early.** Do NOT fall back to raw SQL on these grounds:
> - "[custom date filtering / cohorts]" → [covered by time-dimension specs]
> - "[needs a join]" → [the metric layer already encapsulates its joins]
> - [3–4 more pre-rebutted excuses agents use to skip the semantic layer]

### Date windows & timezone — decide before you query
- **As-of date vs trailing-N days**: [convention for each]
- **"Last week/month"** → the last *complete* calendar week/month, not trailing-7/30
- **Timezone default**: [TZ]; [exception for certain reporting rollups]
- **Freshness lag**: [some] tables settle late — anchor on MAX(date), not "yesterday"

---

# PART 1: MUST KNOW (Read First for Every Request)

## 🚀 Quick Start Workflow
1. **Check for red flags first**: [restricted/PII requests, gated domains,
   high-stakes asks that need extra validation]
2. **Out of scope — escalate, don't guess**: [access requests, pipeline
   troubleshooting, stale dashboards, root-cause assertions, product/pricing
   recommendations] → redirect to [the owning team], don't answer
3. **Clarify the request**: time period, segment, the business decision it informs
4. **Check for existing dashboards**: [per-domain dashboard catalogs]
5. **Identify the data source**: [navigation map below; prefer governed/aggregated tables]
6. **Execute the analysis**: [required filters + adversarial review]
7. **Deliver insights**: show methodology, differentiate observations from interpretations

## 🏢 Business Context

### Entity Disambiguation (MUST CLARIFY)
- **"[Term A]" can mean**: [entity 1] or [entity 2] — always clarify which
- **"[Term B]" can mean**: [entity 1] → [entity 2] → [entity 3] (one-to-many chain)
- **"Users"**: [which identifier gives accurate counts, and which ones inflate them]

### Business Terminology
- [Current product names vs deprecated aliases that still appear as frozen
  values in the data layer — write with the new names, filter with the old]
- [Key internal acronyms]
- **[Headline metric] calculations**: [monthly / default window / leading indicator]
- **Unfamiliar terms — search [internal docs], don't guess**

### Data Integrity Requirements ⚠️
- **NEVER**: make up data/columns; make speculative assertions beyond what data shows
- **ALWAYS**: use safe division; differentiate observations ("data shows X")
  from interpretations ("this suggests Y"); flag limitations

---

# PART 2: HOW TO DO (Follow During Execution)

## 🔧 Technical Execution Guide
- [Managed-connection tools and CLI invocation details]
- **PII protection**: for restricted data, return the SQL for the user to run
  themselves — do not return results

## 📊 Analysis Best Practices Guide
1. Clarify the ask before querying
2. Show your work (filters, inclusions/exclusions, freshness)
3. Clarify denominators
4. Consider sample bias
5. Connect to business impact
6. **Adversarial SQL review (MANDATORY)** — spawn the [sql-reviewer] sub-agent
   for every query before the final answer; blocking findings must be fixed
   and re-reviewed; do not self-certify
7. **Report with provenance** — every answer ends with a footer:
   > **Source:** [semantic layer | governed table | raw exploration] ·
   > **Confidence:** [tier] · **Reviewed:** [reviewer ✓, round N] ·
   > **Freshness:** [max date in the data] · **Owner:** [owning team]

---

# PART 3: DATA REFERENCES & RESOURCES

## 📚 Knowledge Base Navigation
### [Domain A] → `references/[domain_a].md`
- **Use for**: [kinds of questions]
- **Key tables**: [...]
- **Dashboards**: `references/[domain_a]_dashboards.json`

### [Domain B] → `references/[domain_b].md`
- **Use for**: [...]

[... one entry per business domain — a few dozen in total ...]

## ⚠️ Troubleshooting Guide

### When Information Is Missing
- [missing tables / access denied / outdated docs / unknown enum values → what to do]

### Field Naming Gotchas
- Use `[field_x_v2]` NOT `[field_x]`
- [Two similarly-named tables report the same metric at different grains — which to use]
- [Which of two plausible sources is canonical for the headline metric]
- [… a dozen more hard-won one-liners …]
Member discussion